对象存储特点 #
Lance是一个列式存储格式,主要面向S3对象存储,对比本地磁盘存储,对象存储有以下特点:
| 约束 | 后果 |
|---|---|
| 没有真正的目录 | 目录只是 key 前缀,tree/、_indices/{uuid}/ 都是命名约定 |
| 跨对象没有事务 | 不能“同时写多个文件并原子生效” |
| 只有单对象操作是原子的 | PUT / PUT-if-not-exists / DELETE |
| rename 不总是原子 | S3 是 copy+delete,不能用 rename 做提交 |
| list 可能很贵 | 每次列目录都是请求;S3 Express 甚至是 O(n) |
| 请求有速率限制 | 文件名要打散前缀 |
| 一致性模型有差异 | 不能假设“写完立刻在 list 里看到” |
所以任何 **“多文件一起改”**的设计都不可行。
对象存储的这些特点导致了文件组织的设计与面向本地磁盘的设计有很大的差异。在面向本地存储的文件设计中,可以就地修改一个文件,如B-Tree这样的磁盘结构,可以以页面为单位来修改一个数据文件,这个修改操作可以指定修改文件中指定一个范围的内容;但是在对象存储中,由于修改后需要把文件完整上传到对象存储,所以即使修改了一个字节,效果也和整体修改一个文件再上传是一样的。
根据这些特点,面向对象存储的文件组织通常有以下特点:
- 系统中存在一个元文件,记录当前版本由哪些文件组成。
- 已提交的文件,永不修改。
- 如果数据有变更,将通过写新的文件,以及修改元数据文件来指向新文件,以达到变更效果。
根据以上的分析,我们已经了解了对象存储的特点和相应的文件组织应该如何设计,接下来来看Lance的文件组织。
Lance的文件组织 #
Lance虽然和Parquet一样,都是列存格式,但是Parquet只有列存数据文件,Lance有更加完整的一个文件组织,包括:
- 数据集的元文件(manifest)
- 数据文件(和parquet数据文件等价)
- 索引文件
- 事务文件
- 支持tag和branch的元文件
有了这几大类文件,Lance自己就可以实现:MVCC、索引等功能,而如果只采用Parquet,应用层需要自己设计这些文件组织才能实现这些功能,例如 databend。
以下是Lance的文件组织树状图:
{dataset_root}/
├─ data/
│  ├─ {data_file_key}.lance              ← 数据文件(列数据 + 页编码)
│  └─ {data_file_key}/                   ← Blob v2 sidecar(可选)
│     ├─ 00000000000000000000000000000001.blob
│     └─ ...
├─ _versions/
│  ├─ {bit-reversed version}.manifest    ← 或 {version}.manifest(V1)
│  └─ latest_version_hint.json           ← 可选
├─ _transactions/
│  └─ {read_version}-{uuid}.txn
├─ _deletions/
│  ├─ {fragment_id}-{read_version}-{id}.arrow
│  └─ {fragment_id}-{read_version}-{id}.bin
├─ _indices/
│  └─ {index_uuid}/
│     └─ ...                             ← 索引实现自定义
├─ _refs/
│  ├─ tags/{tag}.json
│  └─ branches/{branch}.json
└─ tree/{branch_name}/                   ← 分支 dataset,结构同上
在这个文件组织中,有以下几类文件:
- manifest文件:这是描述整个系统的元文件,也是实现MVCC的关键
- 数据文件:真正存放数据的文件
- 事务文件:提交发生冲突时,用它判断两边的事务能否共存
- 索引文件:保存各类型的索引
- tag和branch文件:用于保存tag和分支的元文件
以下展开详细解释。
manifest文件 #
_versions/目录中保存的是Manifest文件,它是整个系统的元文件, 是某个版本的完整快照:
version
schema
fragments
indices
config
table_metadata
base_paths
feature flags
transaction_file / transaction_section
有了这些信息,读取时只需要读取Manifest文件,就能够得到整个系统的整体组织;相对应的,在修改时,Manifest文件是最后一个被修改的文件,只有当数据文件、事务文件等都修改完成后,才最后更新Manifest文件。
latest_version_hint.json #
_versions/ 目录中除了 *.manifest,还可能有一个 latest_version_hint.json,内容是:
{"version": 42}
它只解决一个问题:怎么廉价地找到最新的 manifest。但并不是所有存储都需要它:
| 存储 | 找最新版本的方式 | 需要 hint |
|---|---|---|
| S3 Standard / GCS / Azure | V2 命名反序,list 第一项即最新 |
否 |
| S3 Express / 本地文件系统 | list 不保证词法有序,全量 list 是 O(n) |
是 |
也就是说:
uses_version_hint = 全局开关 && !list_is_lexically_ordered
在需要它的存储上,读端先读 hint 拿到一个起点版本,再用 HEAD 请求向上探测,直到某个版本不存在;hint 缺失或过期时会回退到完整 listing。它纯粹是优化,删掉不影响正确性,写失败也可以忽略。
回到Manifest文件中,我们重点解释其中的version和fragments字段。
version #
在Lance中,version为单调递增的正整数,不同版本之间的数据,并没有指针用于指向前面版本的Manifest文件。也就是说,不同版本之间,用version做为逻辑时间来进行区分版本之间的先后关系,而不是采用指针的方式。
一个直接的结果:任意版本都可以 O(1) 打开,时间旅行不需要 replay 历史;反过来,删掉一个旧 manifest 也不影响新 manifest 的可用性。
fragments #
其次,fragment是一个逻辑上的概念,它由一组data file的数据文件组成,是Manifest文件里最小的”行单位“,用于表示Lance表的一个不可变数据的分片。也就是说:一个fragment可能对应多个数据文件,而一个数据文件在同一个manifest里只能属于一个fragment,两者是一对多的关系。
需要限定“同一个 manifest 内”,因为跨版本时同一个数据文件会被多个 manifest 引用:
v1.manifest → fragment 0 → data/A.lance
v2.manifest → fragment 0 → data/A.lance
v3.manifest → fragment 0 → data/A.lance
这正是“文件不可变 + manifest 是完整快照”的代价:改一次数据就要写一份新的清单,而旧清单仍然指着那批老文件。也正因为如此,回收空间不能按“某个 manifest 不再引用就删”,而要按所有保留版本 manifest 的引用并集来判断。
一个fragment可能对应多个data file,这样能够方便实现:当修改了一个fragment中的部分数据时,只修改其中的一部分数据文件。
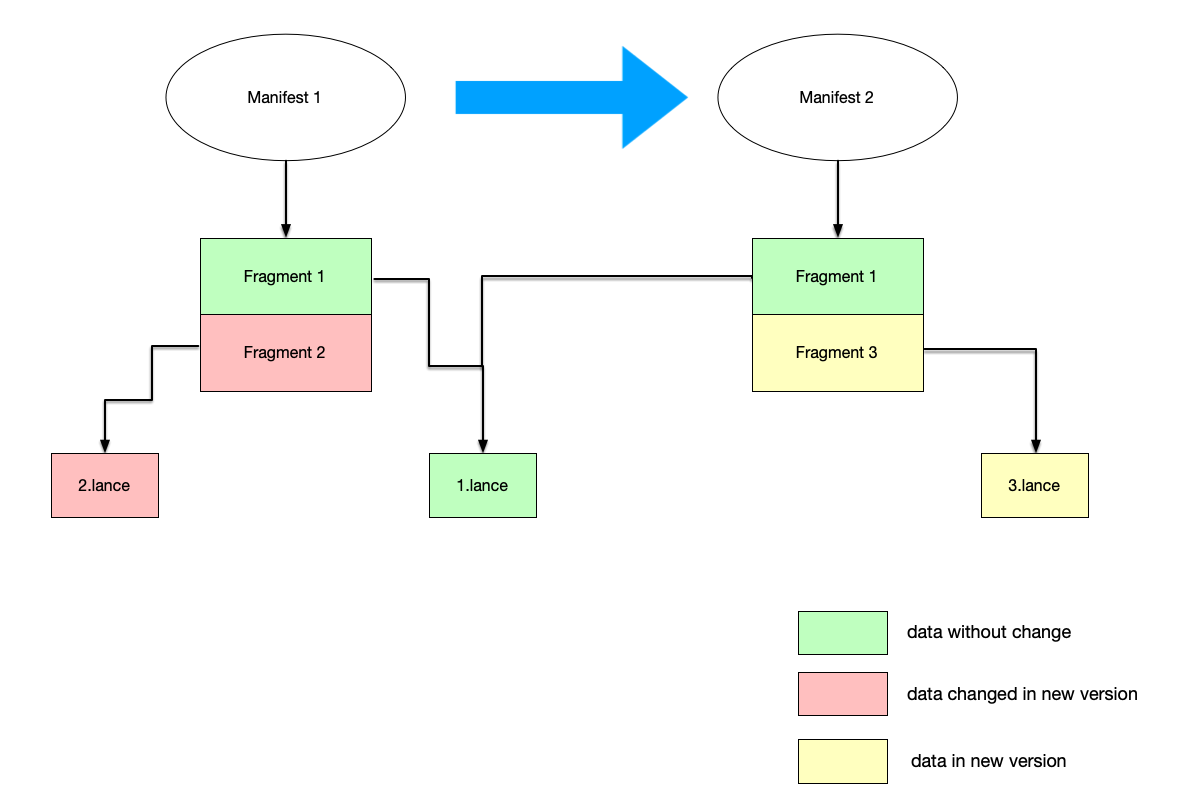
如图所示:
- Manifest 1 文件中,有两个 fragment,其中一个的数据文件为 1.lance,另一个为数据文件 2.lance。
- 某次修改后,Manifest文件更新到了Manifest 2,其中:
- fragment 1 没有修改,因此可以继续被 Manifest 2 使用,
1.lance也原样保留。 - 而 2.lance 文件的数据被修改,根据我们前面提到的”文件在写入后不可被修改“,此时并不是在 2.lance 文件上做修改,而是生成一个新的 3.lance 文件,并用一个新的 fragment 3 指向它。
- fragment 1 没有修改,因此可以继续被 Manifest 2 使用,
注意这里是“旧的 fragment 2 消失,新的 fragment 3 出现”,而不是原地更新 fragment 2。Lance 的 fragment id 是全局高水位、永不复用:如果复用 id,旧版本留下的删除文件、row address、缓存就会错误地指向新数据。
数据文件和删除文件 #
这里把数据文件和删除文件放在一起解释,因为在我看来两者同属于存储数据的文件。
先说位于data目录的数据文件,整体上分为两类:
.lance文件:存放真正的列数据,将在后面的章节详细解释数据文件的格式。.blob文件:blob的值如果特别大,就不会存放在.lance文件中,而是单独存放在.blob文件中。
除了data目录的数据文件以外,_deletions目录还存储了删除文件。这同样是”文件在写入后不可被修改“原则的运用,考虑这样一个场景:对原来的数据进行了某些删除,如果重新写一个新的数据文件,代价太大,取而代之的是,将被删除的数据id写到单独的删除文件中。
删除文件的命名是:
_deletions/{fragment_id}-{read_version}-{id}.{arrow|bin}
| 扩展名 | 格式 | 适用 |
|---|---|---|
.arrow |
Arrow IPC,行号列表 | 稀疏删除 |
.bin |
Roaring bitmap | 稠密删除 |
文件名带上 fragment_id 和 read_version,既保证了唯一性,也让旧版本 manifest 可以继续引用旧的删除文件。
因此,Fragment结构体中,有两个成员分别保存该fragment的数据文件和删除文件:
pub struct Fragment {
    pub files: Vec<DataFile>,
    pub deletion_file: Option<DeletionFile>,
    // ....
}
举一个例子,fragment中原有的数据文件内容有三行数据 ["hello", "string", "world"],某次更新删除了第二行数据,这时不需要重新生成一个数据文件 ["hello", "world"],而只需要新增一个删除文件保存第二行数据被删除即可,在进行读写时,自动过滤掉被删除的那一行数据。
事务文件 #
_transactions目录下存储的是事务文件,命名为 {read_version}-{uuid}.txn。文件内容是 lance.table.Transaction protobuf 的原始编码,没有 header、footer 或长度前缀。
它记录的是“意图”而不是“结果”:
read_version
uuid
operation(Append / Delete / Overwrite / Update / Rewrite / ...)
  └─ 各自需要的参数
比如 Append 只知道“要加这些 fragments”,不知道它们最终的 fragment id;最终的 id、manifest 版本号、索引覆盖范围,都要等构建 manifest 时才算出来。
它用于在提交时:
- 重试时让输家知道赢家做了什么
- 冲突检测
- 历史审计
关于事务的详细内容,也将在后续章节展开分析。
索引文件 #
_indices目录保存索引文件,每个索引段一个 UUID 目录:
_indices/{uuid}/
这个 UUID 就是写出索引时生成的 IndexMetadata.uuid,不是索引名。同名索引可以对应多个物理段,替换、裁剪、重映射都发生在段这一级,目录名保持不变。
目录内容由索引类型来决定:
IVF-PQ         → centroid / PQ codebook / partition 数据
BTREE          → 排序页 + 页索引
FTS / inverted → posting list / 文档表
bitmap         → Roaring bitmap
zonemap        → 统计信息
FRAG_REUSE     → fragment 复用映射
MEM_WAL        → MemWAL 状态
和 data file 一样,索引文件也可能被多个版本的 manifest 引用。
Tag 与 Branch 元数据 _refs/
#
_refs 位于 main root,由所有分支共享,存放两类命名引用。
Tag 和 Branch 分别解决以下问题:
Tag    = 给某个 (branch, version) 起个名字
         解决“怎么稳定地指向一个快照”

Branch = 从某个版本分叉出另一条版本链
         解决“怎么在互不影响的前提下各自演进”
简而言之:Tag解决命名问题,而Branch解决分叉问题。
Tag #
Tag文件存放在 _refs/tags/{tag}.json文件中,内容大致是:
{
  "branch": null,
  "version": 5,
  "createdAt": "...",
  "updatedAt": "...",
  "manifestSize": 1024,
  "metadata": {}
}
branch 为 null 表示 main,所以 tag 指向的永远是 (branch, version) 这个二元组,而不是裸的版本号。
用名字代替版本号
平台侧不该硬编码 version=42:
ds = lance.dataset(uri, version=42)               # 脆弱
ds = lance.dataset(uri, version="prod-2026-11")   # 可读、可改
给“重要版本”一个稳定锚点
训练数据集快照  → tag "training-v1"
生产发布点      → tag "prod"
评测基线        → tag "baseline-2026-11"
防止被 GC 删掉
tag 指向的版本默认进入 cleanup 的 working set
只要 tag 还在,这个版本就不会被回收
这是 tag 唯一“有副作用”的能力:它是一个保留策略的把手。
让名字可以移动
prod: v5 → v7
只需要 tags.update("prod", 7),不改任何数据。
这一点和 Git 不同:Git tag 默认不可移动,Lance tag 是可 re-point 的别名。
Tag 不解决:
✗ 不隔离写入:不能“在 prod 上改数据而不影响别人”
✗ 不产生新版本
✗ 不复制数据
✗ 不提供并行开发
Branch #
Branch文件存放在 _refs/branches/{branch}.json文件中,另外在tree/{branch}/目录中的是某个分支的数据文件,这个目录的布局和一般的数据文件布局一样(data/、_versions/、_indices/ 一应俱全)。
一个容易踩的坑:分支名里的 / 在两处编码方式不同。
branch = "bugfix/issue-123"

_refs/branches/bugfix%2Fissue-123.json   ← 元数据文件,斜杠被编码
tree/bugfix/issue-123/                    ← 数据目录,真实嵌套
前者必须扁平(否则会被当成子目录),后者有意的层级化(便于按前缀清理)。
Branch 可以创建分支,从而实现 并行演进,互不干扰。
main        → 线上数据
tree/exp-a  → 实验者 A 的清洗逻辑
tree/exp-b  → 实验者 B 的 schema 变更
三条链各自 _versions/、各自 data/、各自 _indices/。
需要注意的是,分支的版本号是各自独立计数的:
main v5 → create_branch("dev", 5) → dev v5
这里的 dev v5 和 main v5 是两个完全不同的 manifest,只是版本号恰好相同(fork 时继承)。这也是 tag 必须带上 branch 的原因。
不复制数据的隔离
创建分支是 shallow clone:
manifest.base_paths → 父分支
data_file.base_id   → 父分支
所以:
1 TB 的 main
create_branch("exp") 只写一个 manifest + 一个 JSON
对比 deep_clone:要真拷贝所有文件。
支持“试错后丢弃”
create branch → 写入 → 发现问题 → delete_branch
main 完全没被碰过
支持“从任意点分叉”
ds.create_branch("fix", 12)           # 从当前分支 v12
ds.create_branch("exp", "v2-prod")    # 从 tag
ds.create_branch("child", ("dev", 7)) # 从别的分支 v7
天然适合“多租户 / 多环境”
tree/{branch_name}/ 目录存储的是分支的数据文件,结构和顶层数据文件一样:
tree/tenant-a
tree/tenant-b
tree/staging
tree/prod
每个都是完整 dataset,可以独立读写。
Branch 不解决:
✗ 不提供命名快照:分支指向“最新”,不指向某个固定版本
✗ 不自动合并:Lance 没有 merge/rebase 分支的语义
✗ 不共享版本号:各自从 fork 版本开始独立计数
✗ 不是零成本:新写入仍然占空间
总结下来:
Tag    → 命名与保留
         把“某个版本”变成可读、可移动、可保护的名字

Branch → 分叉与隔离
         用零拷贝的浅引用,开出一条可以独立演进的版本链

Tag 管“指向哪里”,Branch 管“在哪里写”。
小结 #
把这些文件按“谁决定谁”串起来,关系是:
                    _versions/*.manifest
                    (唯一真相、完整快照、提交点)
                             │
        ┌────────────────────┼────────────────────┐
        │ fragments[]        │ index_section      │ transaction_file
        ▼                    ▼                    ▼
  data/*.lance         _indices/{uuid}/     _transactions/*.txn
  data/{key}/*.blob                         (或 manifest 内联副本)
        │
        │ fragment.deletion_file
        ▼
  _deletions/*
对应的写入顺序:
1. 写 data files / blob sidecar
2. 写 deletion files
3. 写 index files
4. 写 _transactions/*.txn
5. 条件写 _versions/*.manifest   ← 前四步到此才对读者可见
以及两条贯穿全文的结论:
- manifest 是唯一真相:读端只需要 manifest,不需要事务文件;
- 文件不可变、可共享:一个 data file / index file 可能被多个版本的 manifest 同时引用,所以“删掉旧 manifest”并不等于“删掉它引用的文件”。